单细胞类型注释:把 marker、图和判断写进同一份记录
10x 单细胞分析入门 · 第 09 篇
聚类有了编号,还没有细胞类型。这里先计算候选 marker,再看组合表达,最后把“类型”和“依据”写入表格,按聚类 ID 匹配回对象。
输入是 results/03-clustered.rds。本篇完成的是 PBMC 的教学性人工注释,不包含已独立验证的参考映射,也不会宣称把全部细胞亚型准确分完。判断不足的群可以保留 Unknown,但要写出尚缺的证据。
先生成 marker 和注释模板
cd ~/sc-course
Rscript scripts/04-markers.R "$PWD" > logs/04-markers.log 2>&1
echo $?
head -n 6 results/04-top10-markers.csv
cat results/04-annotation.tsv
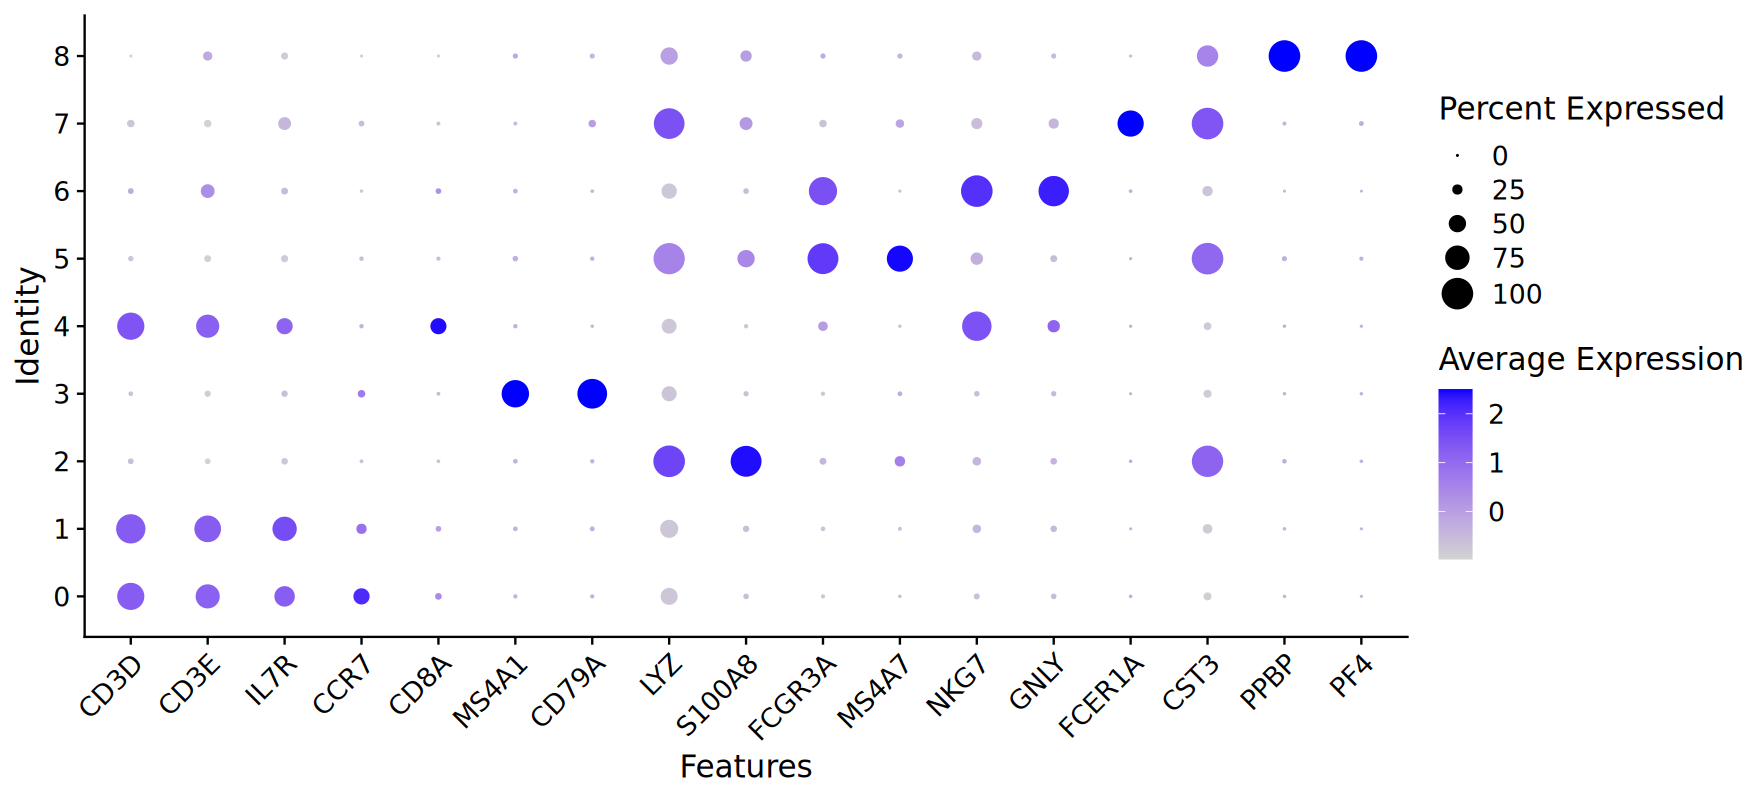
脚本输出完整候选表、每群前 10 个候选、marker DotPlot、4 个基因的 FeaturePlot,并生成 04-annotation.tsv。重复运行不会覆盖已经存在的人工注释表。
核心调用如下:
library(Seurat)
pbmc <- readRDS("~/sc-course/results/03-clustered.rds")
Idents(pbmc) <- factor(pbmc$cluster_res_0_5,
                       levels = sort(unique(pbmc$cluster_res_0_5)))
markers <- FindAllMarkers(pbmc, assay = "RNA", only.pos = TRUE,
                           test.use = "wilcox", min.pct = 0.25,
                           logfc.threshold = 0.25, random.seed = 42)
这是按当前聚类区分表达特征,帮助命名细胞群。它不是疾病与对照之间、以供体为单位的差异表达检验。候选 marker 和正式条件差异不能只换个输出文件名就互相替代。
表中每列怎样帮助判断
| 列 | 用法 | 容易误读的地方 |
|---|---|---|
gene | 候选特征名称 | 第一名不一定最有生物学特异性 |
avg_log2FC | 群间表达差异的方向与幅度 | 不是该基因的绝对表达量 |
pct.1 / pct.2 | 目标群和其余细胞的检出比例 | 少量细胞的强表达可能抬高均值 |
p_val_adj | 该次候选检验的校正结果 | 极小 P 值不能替代类型证据 |
本例按 log fold change 和检出比例排序展示候选,不将这份前十名列表当作固定 marker 数据库。参数含义以 FindAllMarkers 文档为准。
用组合 marker,而不是只找一个阳性基因
下面是本例的核查面板,作为检查起点,不能跨组织直接套用:
| 候选群 | 先看哪些基因 | 还要排查什么 |
|---|---|---|
| T 细胞 | CD3D、CD3E;结合 IL7R、CCR7、CD8A | 不凭 NKG7 单独把细胞毒性 T 细胞叫 NK |
| B 细胞 | MS4A1、CD79A | 低表达或少数阳性是否足够支持整群命名 |
| 单核细胞 | LYZ,结合 S100A8、FCGR3A、MS4A7 | FCGR3A 也可能出现在其他群,需要组合证据 |
| NK 候选 | NKG7、GNLY,结合 CD3 基因 | T/NK 边界和低测序深度造成的漏检 |
| 树突细胞候选 | FCER1A、CST3 | 稀有群规模、与单核细胞的关系 |
| 血小板相关候选 | PPBP、PF4 | 背景 RNA、少量细胞和混合信号 |
这一面板基于 PBMC 常用表达特征及Seurat PBMC 示例中的注释参考,本文把它变成待核对的证据组合,不预先把所有群定死。
DotPlot(pbmc, features = c("CD3D", "MS4A1", "CD79A", "LYZ", "NKG7", "GNLY")) +
  RotatedAxis()
FeaturePlot(pbmc, features = c("CD3D", "MS4A1", "LYZ", "NKG7"), ncol = 2)
DotPlot 的点大小与颜色表达不同信息,具体以图例和 DotPlot 文档核对。颜色按特征缩放后,不能拿不同基因间的颜色深浅直接比较绝对表达。
填写注释表,保留不确定项
打开 results/04-annotation.tsv。保持制表符分隔,每个聚类只出现一行。下列是填写方式示意,编号 example 不是本例的真实聚类 ID:
cluster	cell_type	evidence
example T_candidate CD3D/CD3E enriched; subtype unresolved配套提供本次运行的注释参考。先对照当前的聚类大小、marker 和图,再决定是否采用。换了版本、阈值或随机种子后,编号可能变,不能整表盲拷。
| 本次聚类 | 细胞数 | 教学注释 | 判断保留到哪一级 |
|---|---|---|---|
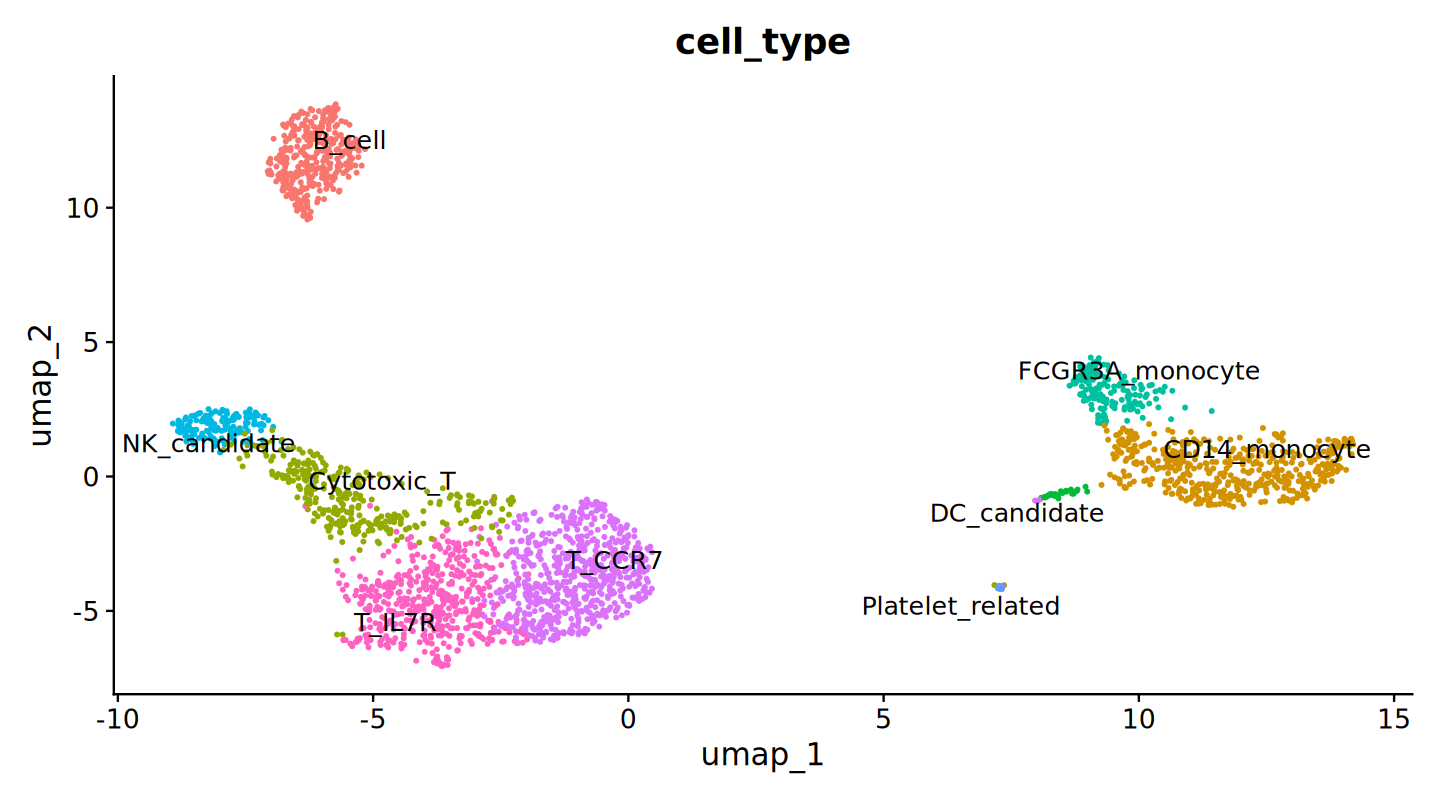
| 0 | 655 | T_CCR7 | CCR7/LEF1/TCF7 支持的 T 细胞状态,不把标签当作已验证亚型 |
| 1 | 485 | T_IL7R | IL7R/CD40LG 等支持的 T 细胞状态 |
| 2 | 480 | CD14_monocyte | LYZ/S100A8/S100A9/CD14 支持的单核细胞群 |
| 3 | 344 | B_cell | MS4A1/CD79A 等支持的 B 细胞群 |
| 4 | 322 | Cytotoxic_T | 结合 CD3、CD8A 和细胞毒相关表达 |
| 5 | 162 | FCGR3A_monocyte | 结合 LYZ、FCGR3A、MS4A7 等 |
| 6 | 144 | NK_candidate | 结合 GNLY/NKG7 与较低 CD3 信号,保留候选表述 |
| 7 | 32 | DC_candidate | FCER1A/CD1C/CLEC10A 支持,小群保留候选表述 |
| 8 | 14 | Platelet_related | PPBP/PF4/GP9/ITGA2B 支持的血小板相关信号,仍需排查背景与混合 |
本次输出 3,426 行候选 marker。行数依赖检验参数和版本,不是正确运行的通用标准。表中的类型均是当前案例的人工教学判断,没有独立实验验证。
证据可以包括支持 marker、冲突信号、低置信度原因。若暂时无法确定,可写 Unknown 并说明原因,例如“cluster too small; mixed lineage markers”。模板中的 pending review 必须替换,否则最终脚本会停止。
按 ID 匹配回对象
Rscript scripts/05-annotate.R "$PWD" > logs/05-annotate.log 2>&1
echo $?
cat logs/05-annotate.log
脚本会检查重复聚类 ID、缺失行、空类型和未填写依据。通过后按 match 匹配,而不是按表格行号赋值。它保留原有 cluster_res_0_5,另外新增 cell_type 与 annotation_evidence。
成功后有 05-annotated.rds、05-cell-metadata.csv、05-cell-type-counts.csv 和 05-cell-types.png。检查类型数量表,确认没有因为拼写差异将一个类型拆成两个名字。
最后做两项复核
第一,把注释表行顺序打乱,保存后重跑最终脚本。结果应仍按聚类 ID 对齐,细胞类型数量不变。第二,给同一聚类重复一行,脚本应报错停止。练习结束后恢复正确的表。
两项检查帮助确认元数据处理没有依赖“碰巧正确”的行顺序;它们不能证明人工类型判断正确。生物学复核仍要结合组织来源、更多特征、必要的参考映射和实验信息。
当前单样本练习到这里完成。将目录中的交付文件清单逐项核对后,再开始设计多供体比较,避免把单供体教学结果写成组间研究结论。