单细胞 RNA 质控:留下过滤依据,再选择阈值
10x 单细胞分析入门 · 第 07 篇
本节生成两类结果:过滤前后分布图,以及每个条形码的保留/剔除记录。即使以后决定放宽阈值,也能知道哪些细胞受到影响。
输入为上一节的 results/01-imported.rds。这一步包含基础指标过滤与阈值敏感性对照,没有完成双细胞算法检测或环境 RNA 校正,不能把输出直接称为“全部清洗完成”的数据。
运行并检查产物
cd ~/sc-course
Rscript scripts/02-qc.R "$PWD" > logs/02-qc.log 2>&1
echo $?
cat logs/02-qc.log
head -n 6 results/02-qc-sensitivity.csv
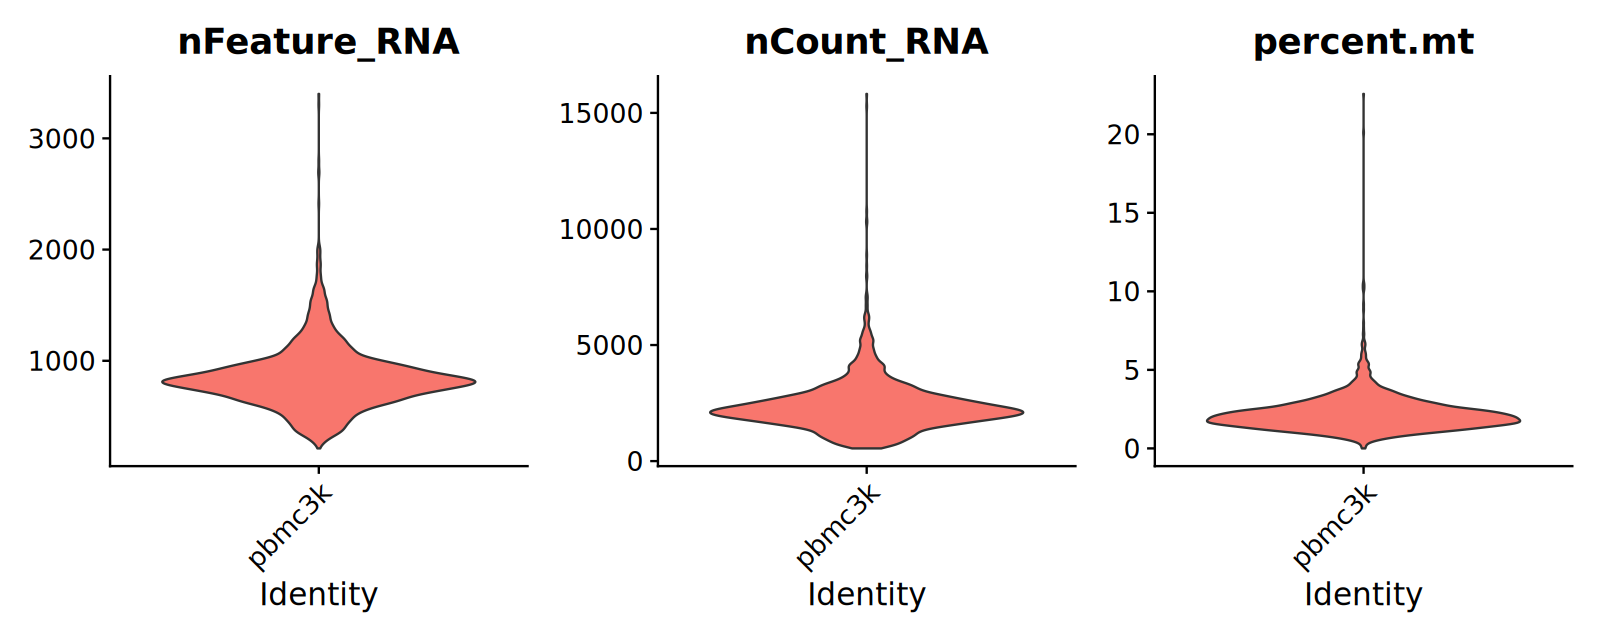
主要输出为 02-filtered.rds、02-qc-decisions.csv、02-qc-sensitivity.csv 和过滤前后两张 PNG。PNG 是脚本直接绘出的结果,没有手工重绘数值。
先检查线粒体基因有没有匹配上
在 R 中拆解这一段:
library(Seurat)
project <- normalizePath("~/sc-course")
pbmc <- readRDS(file.path(project, "results/01-imported.rds"))
mt <- grep("^MT-", rownames(pbmc), value = TRUE)
length(mt)
head(mt)
stopifnot(length(mt) > 0)
pbmc[["percent.mt"]] <- PercentageFeatureSet(pbmc, features = mt)
summary(pbmc$percent.mt)
这里采用人类基因 symbol 的 MT- 前缀。小鼠常见名称习惯不同,Ensembl ID 也不能直接用这个正则。若所有细胞的比例都是零,先检查是否匹配到基因,不要据此宣称样本质量极好。
按 PercentageFeatureSet 的定义,计算的是指定基因的 counts 之和除以该细胞的全部 counts,再乘 100。因此它随所用 assay、特征集合和计数处理方式变化。
看分布,再写规则
VlnPlot(pbmc,
        features = c("nFeature_RNA", "nCount_RNA", "percent.mt"),
        pt.size = 0, ncol = 3)
FeatureScatter(pbmc, feature1 = "nCount_RNA", feature2 = "nFeature_RNA")
基因数很少的液滴值得检查;高基因数可能包含双细胞,也可能属于 RNA 丰富的细胞类型。高线粒体计数比例也要结合样本与分布解释。单看一项指标无法解决所有问题。
本例采用一组明确的教学规则,便于与常见 PBMC 入门流程对照:nFeature_RNA > 200、nFeature_RNA < 2500、percent.mt < 5。这些值不应直接复制到肿瘤、组织单核或其他物种的数据中。
meta <- pbmc[[]]
meta$low_features <- meta$nFeature_RNA <= 200
meta$high_features <- meta$nFeature_RNA >= 2500
meta$high_mt <- meta$percent.mt >= 5
meta$keep <- !(meta$low_features | meta$high_features | meta$high_mt)
table(meta$keep)
三个剔除原因可以重叠,因此各项失败数量相加可能大于总剔除数。配套脚本保留这些独立布尔列,另加最终 keep。这比只保存过滤后的对象更容易复核。
做一次阈值对照
保持基因数下限为 > 200,组合改变上限与线粒体比例阈值。本次实测结果如下,同样写入 02-qc-sensitivity.csv:
| 基因数上限 | 线粒体比例上限 | 保留细胞 | 相比基线新增 |
|---|---|---|---|
| < 2,500 | < 5% | 2,638 | 0 |
| < 4,000 | < 5% | 2,643 | 5 |
| < 2,500 | < 10% | 2,689 | 51 |
| < 4,000 | < 10% | 2,694 | 56 |
这里仅统计保留数量,不声称某组阈值“最优”,也没有为四组全部重跑聚类。基线共剔除 62 个条形码:本次有 5 个触发基因数上限、57 个触发线粒体比例上限,低基因数规则未触发;真实项目仍要保留可能重叠的独立原因列。
先问是哪项阈值导致差异。如果放宽上限新增了较多细胞,可以提取这些条形码,查看它们的计数分布、双细胞评分和候选细胞类型,再决定正式项目如何处理。教学基线保持第一行规则。
保存细胞名单与过滤对象
kept_barcodes <- rownames(meta)[meta$keep]
filtered <- subset(pbmc, cells = kept_barcodes)
stopifnot(ncol(filtered) == sum(meta$keep))
saveRDS(filtered, file.path(project, "results/02-filtered.rds"))
还应检查过滤前后各指标的分布,而不是只读“删了几个细胞”。后面的聚类图可能看起来很整齐,但如果某类细胞被阈值系统性剔除了,整齐本身不能证明过滤合理。
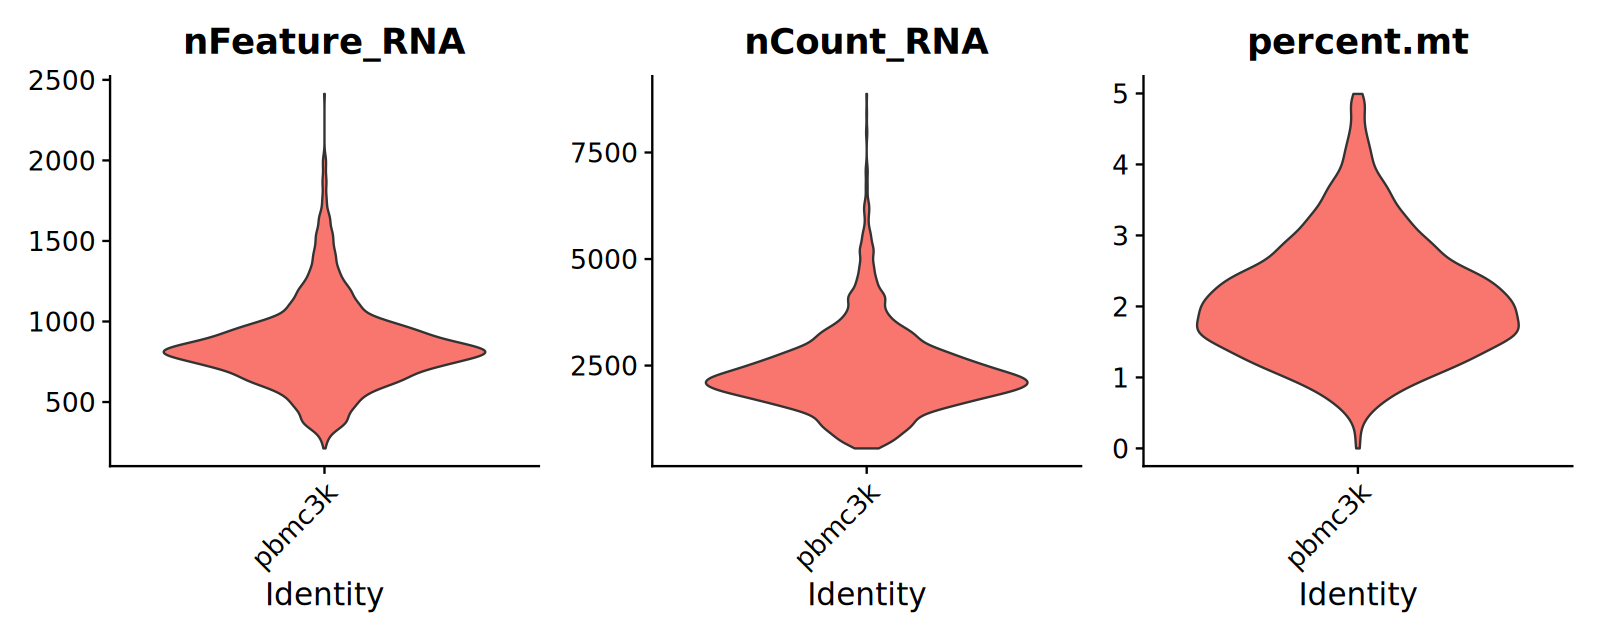
在本例未归一化阶段,Seurat 可能提示没有 data layer 而改用 counts。这里绘出的三项指标来自元数据;提示本身不代表归一化失败,因为归一化还未开始。应结合退出码和实际输出判断。
双细胞与环境 RNA 留下什么记录
基础阈值不等于双细胞检测。同类型双细胞未必拥有极端的基因数,混合表达也不能仅凭两个 marker 阳性就下结论。正式分析应选择适用工具、按上样批次运行并保存评分与判定依据;本阶段只做基础质控,暂不输出双细胞标签。
环境 RNA 可能在并不属于该细胞的表达中留下信号。若只有 filtered 矩阵,部分依赖背景液滴的校正流程所需输入并不齐全。报告中写“未进行此项校正”,比宣称已经去除所有污染更准确。
练习:在 02-qc-decisions.csv 找出一个被剔除的条形码,说明是哪条规则触发。随后核对阈值对照表,再进入聚类实操。