Seurat 聚类实操:从归一化到 PCA 和 UMAP
10x 单细胞分析入门 · 第 08 篇
从过滤后的对象出发,完成归一化、选高变基因、缩放、PCA、邻接图、聚类与 UMAP。每一步只保留本例需要的参数,再用检查点确认对象仍对应同一组细胞。
输入为 results/02-filtered.rds。先运行:
cd ~/sc-course
Rscript scripts/03-cluster.R "$PWD" > logs/03-cluster.log 2>&1
echo $?
tail -n 20 logs/03-cluster.log
cat results/03-cluster-sizes.csv
输出包括聚类对象、PCA elbow 图、聚类 UMAP、UMAP 上的质控指标图、细胞坐标表。下列代码解释同一个脚本的步骤,在 R 中执行。
归一化与高变基因
library(Seurat)
pbmc <- readRDS("~/sc-course/results/02-filtered.rds")
pbmc <- NormalizeData(pbmc, normalization.method = "LogNormalize",
                      scale.factor = 10000, verbose = FALSE)
pbmc <- FindVariableFeatures(pbmc, selection.method = "vst",
                             nfeatures = 2000, verbose = FALSE)
length(VariableFeatures(pbmc))
本例用 LogNormalize,使细胞计数按总量缩放后再做对数转换。它没有消除所有技术差异,也不等同于多样本批次校正。
高变基因用于后续降维,不表示其他基因从原始 counts 中全部删除。2000 是本例的工作参数,不是所有数据必须相同的数量。流程定义可查 NormalizeData 与 FindVariableFeatures。
缩放并查看 PCA
pbmc <- ScaleData(pbmc, features = VariableFeatures(pbmc), verbose = FALSE)
pbmc <- RunPCA(pbmc, features = VariableFeatures(pbmc),
               npcs = 30, seed.use = 42, verbose = FALSE)
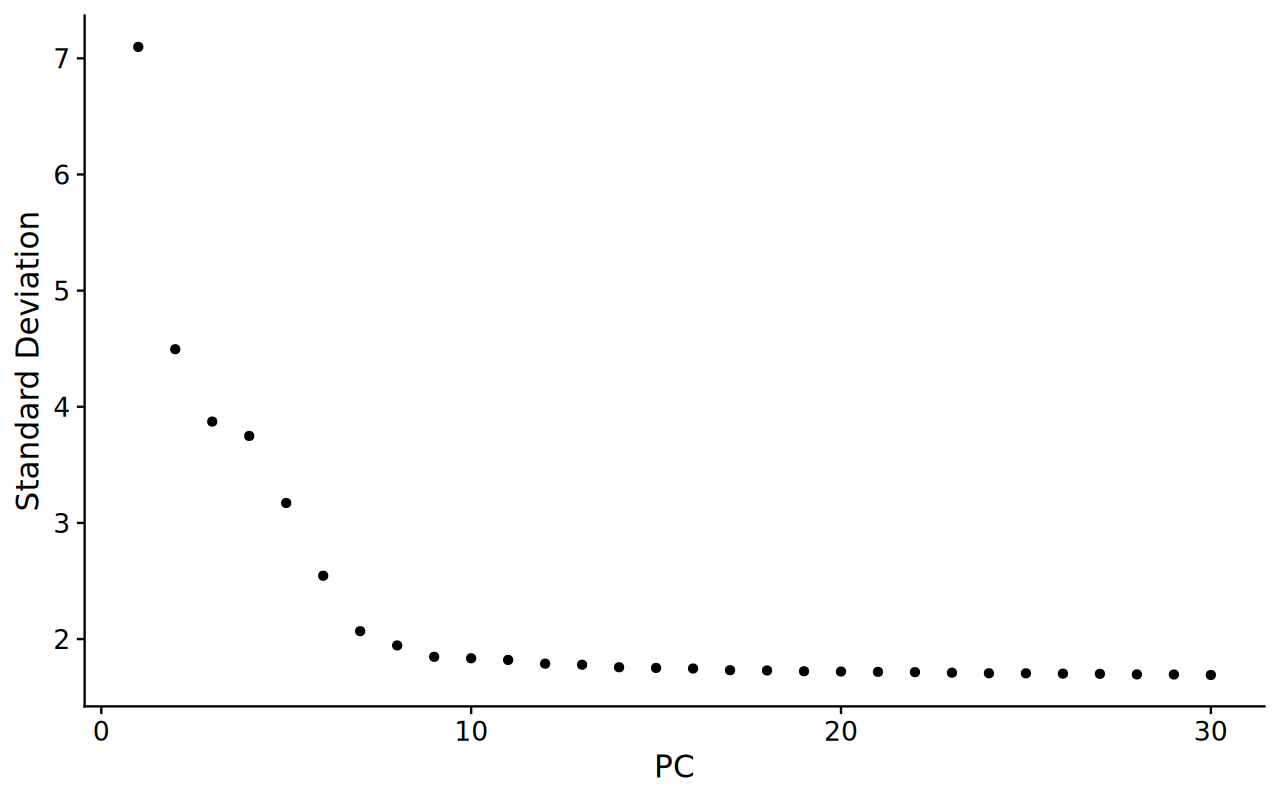
ElbowPlot(pbmc, ndims = 30)
head(Embeddings(pbmc, "pca")[, 1:3])
缩放仅针对选出的高变基因,避免为所有基因创建不必要的稠密中间矩阵。PCA 用这些特征建立低维表示,后面使用其中前 10 个主成分。
先看 elbow 图,再检查 PCs 的载荷是否由计数深度、线粒体或某一技术因素主导。曲线转折提供线索,不能自动替你决定生物学上“正确”的维度数。
聚类依赖邻接图,不依赖图上画出的岛
pbmc <- FindNeighbors(pbmc, dims = 1:10, verbose = FALSE)
pbmc <- FindClusters(pbmc, resolution = 0.5, algorithm = 1,
                     random.seed = 42, verbose = FALSE)
pbmc$cluster_res_0_5 <- as.character(Idents(pbmc))
table(pbmc$cluster_res_0_5)
FindNeighbors 使用 PCA 空间的邻近关系建图;algorithm = 1 选择原始 Louvain。resolution 影响划分粒度,细胞数和数据结构也会改变结果,不能仅按“应该分出九群”倒调参数。FindClusters 文档说明了算法与聚类结果存储方式。
脚本额外保存 cluster_res_0_5。以后尝试另一种 resolution 时,seurat_clusters 可能被覆盖;保留带参数含义的字段可以减少比较时的混淆。聚类编号只是本轮划分的标签,不自带细胞类型。
运行 UMAP,并确认条形码顺序
pbmc <- RunUMAP(pbmc, dims = 1:10, umap.method = "uwot",
                metric = "cosine", seed.use = 42, verbose = FALSE)
stopifnot(identical(rownames(Embeddings(pbmc, "umap")), colnames(pbmc)))
DimPlot(pbmc, reduction = "umap", label = TRUE)
FeaturePlot(pbmc, features = c("nCount_RNA", "percent.mt"), ncol = 2)
这里显式使用 R 的 uwot,不需要为此安装 Python 的 umap-learn。相关参数见 RunUMAP。固定种子帮助复跑,但跨版本与平台仍可能使坐标或编号变化。
看两张图:第一张观察聚类分布,第二张排查分群是否强烈跟随计数或线粒体指标。如果一个边缘群同时有异常质控分布,先回查,再考虑给它命名。
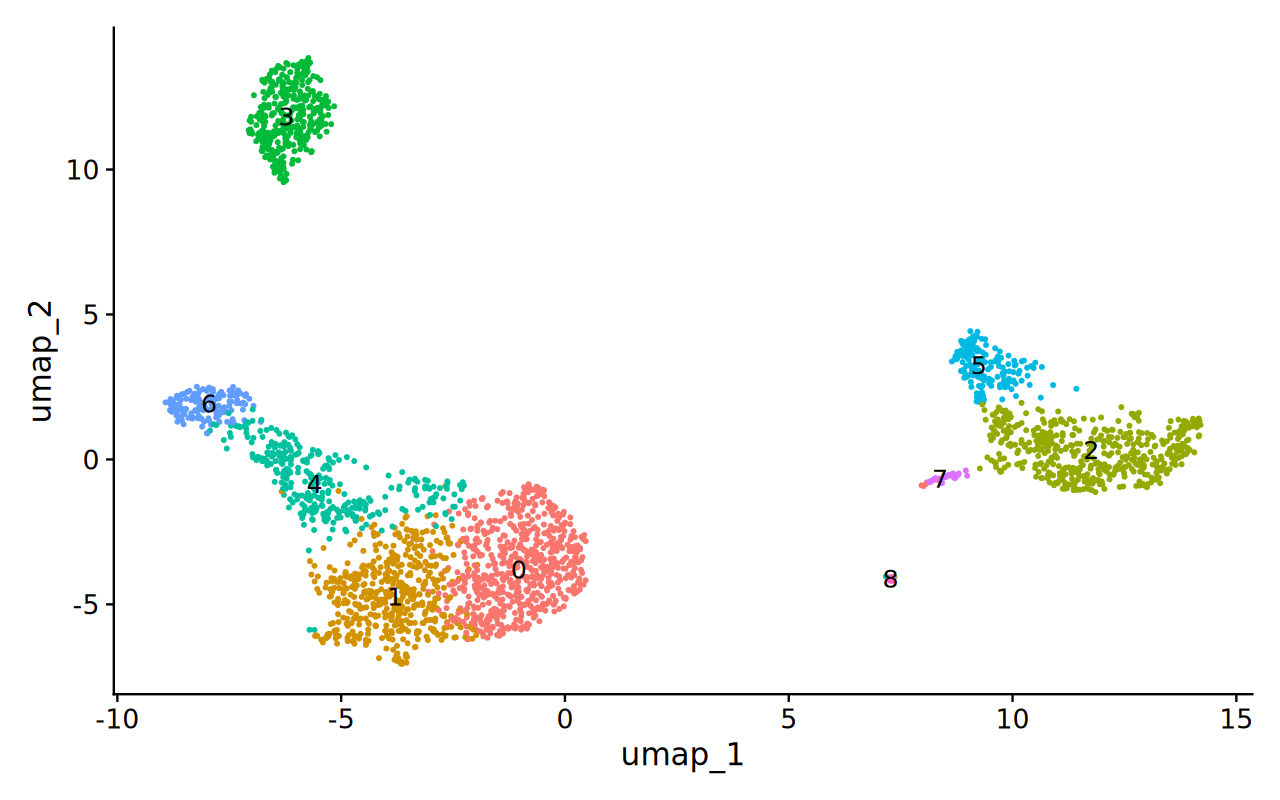
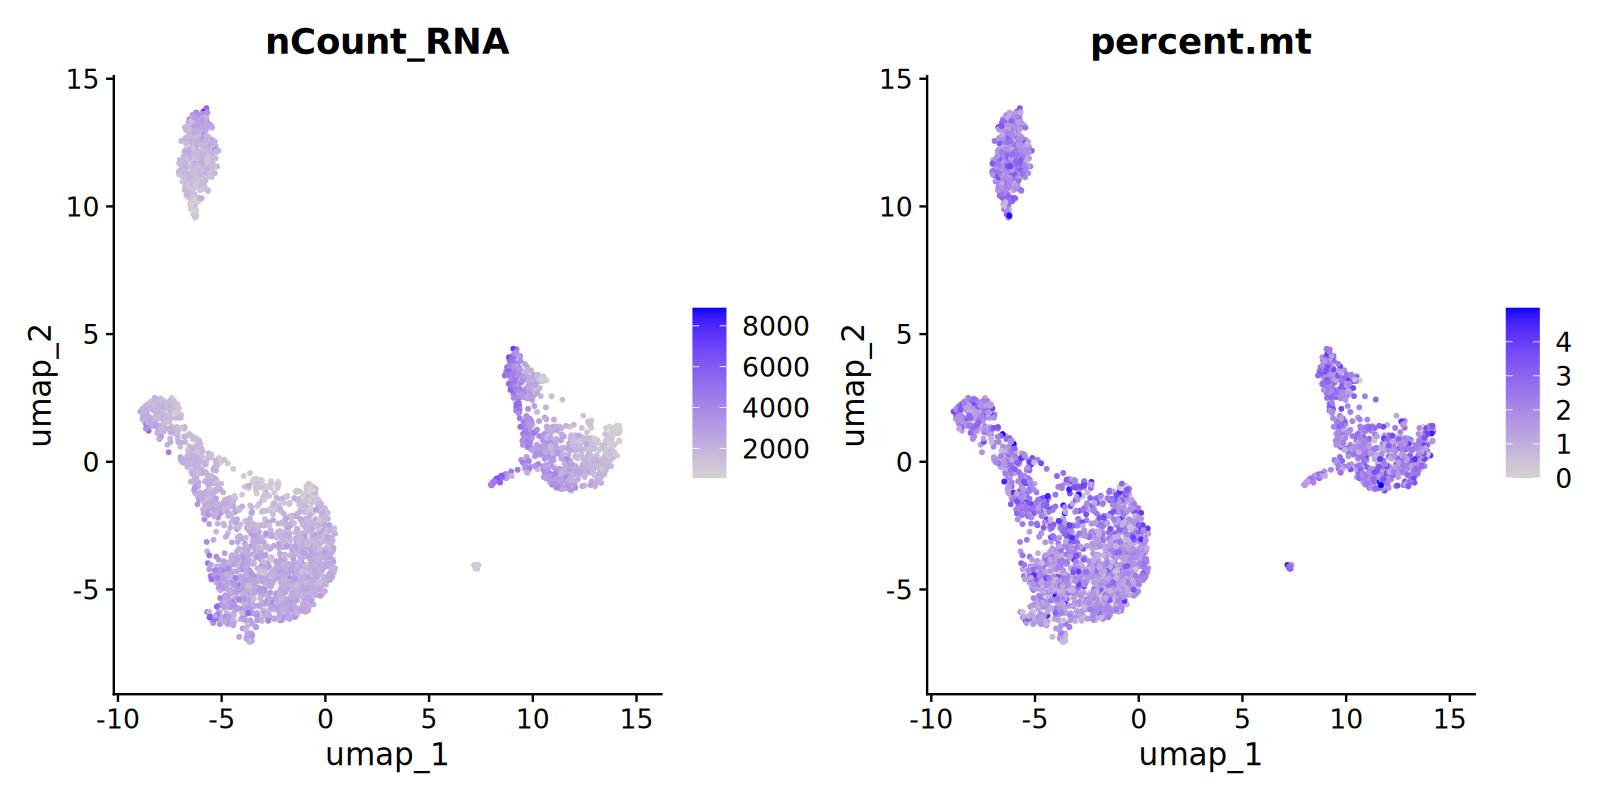
UMAP 是可视化。两群在二维图上相距较远,不足以证明它们在发育时间上相距更远;桥状分布也不自动等于分化轨迹。
保存与重新检查
saveRDS(pbmc, "~/sc-course/results/03-clustered.rds")
check <- readRDS("~/sc-course/results/03-clustered.rds")
stopifnot(ncol(check) == ncol(pbmc))
stopifnot(all(c("pca", "umap") %in% Reductions(check)))
不要只保存 PNG。PNG 无法恢复原始表达、聚类参数和元数据关系,后续 marker 分析还需要对象。
做一个有边界的参数练习
复制对象到 alternative,只改邻接图使用的维度为 1:15,重建邻接图和聚类,另存结果。比较每个细胞的分群变化和 marker,而不是只比较岛的形状。不要覆盖教程基线对象,否则下一篇的注释参考就不再对应当前运行。
遇到 No variable features 先查是否运行高变基因步骤;找不到 pca 先查输入对象是不是过滤检查点。不要把所有报错都归结为“Seurat 版本问题”。下一篇以 marker 证据注释。